
机器东说念主究竟应该走VLA(Vision-Language-Action Model 视觉-说话-当作模子的缩写)阶梯,照旧宇宙模子阶梯?6月,北京智源大会现场,围绕具身智能的时间阶梯之争再次成为行业焦点。
在这次大会具身产业CEO论坛,智平方首创东说念主兼CEO郭彦东对这一瞥业争论抛出明确谜底:宇宙模子不是VLA的竞争阶梯,而是VLA体系中的中枢构成部分;而辞宇宙模子与VLA会通之后,类脑架构将成为下一代机器东说念主大脑的遑急演进想法。
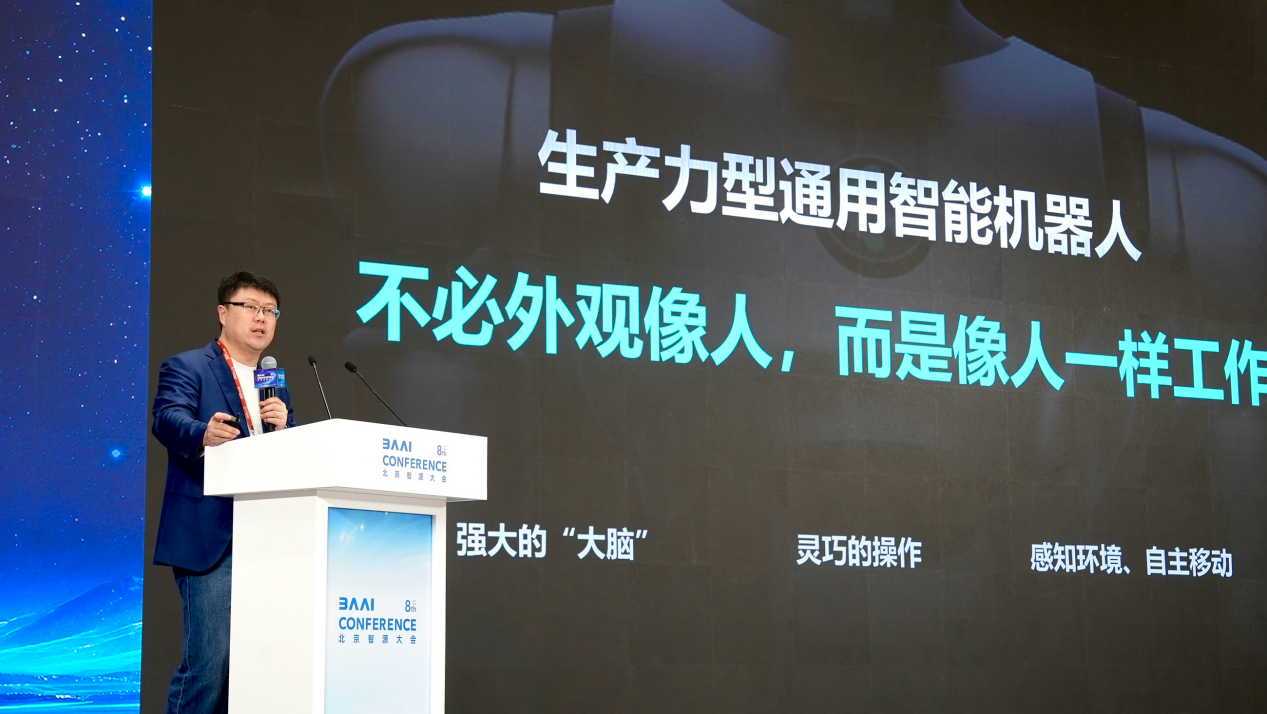 不少筹商者以为,机器东说念主领先需要配置对物理宇宙的表露才略,身手进一步产生可靠举止;也有东说念主以为,VLA奏凯从视觉和说话生成当作,是更高效、更推行的时间旅途。
郭彦东以为,从生命演化的角度来看,行动才略并不是孤苦产生的。生命领先需要感知环境、表露环境,然后才会产生行动。
也等于说,宇宙模子持重表露宇宙,而VLA持重作用于宇宙,两者并非对立相干,而是自然谐和的全体。
他在演讲中指出,刻下被泛泛筹商的“宇宙模子”,内容上并不是物理限定脱手,而是靠海量数据查验出来的。“数据满盈多,模子就知说念水杯逾越桌面会下跌、手机屏幕使劲敲可能会碎——这不是物理限定的追想,而是大数据学习的效劳。”
基于这一判断,郭彦东给出了VLA的界说:VLA是多种模态会通的大数据脱手的端到端模子架构的总称。在这个界说下,宇宙模子与VLA莫得内容折柳,更不是替代相干。
“宇宙模子措置的是对物理环境进行广博、包含时间维度的4D估量,它是一个极端好的空间基础模子,是VLA空间感知的一部分,能匡助机器东说念主大脑越来越好。”
他进一步器具体任务诠释了为什么两者必须会通:“要是不把宇宙模子湮灭在VLA内部,许多任务王人备作念不了。比如沏茶要先拿茶包再倒水,作念咖啡要先拿杯子再接水——这些推理领略逻辑靠说话模子更容易完成。宇宙模子擅长的是短程估量,比如水杯围聚桌边可能掉落。惟有把两者湮灭,机器东说念主才既能作念短程物理估量,又能作念长程任务盘算推算。”
除了在VLA中会通宇宙模子的估量才略,智平方还诳骗宇宙模子生成真的环境中难以聚积的旯旮数据(corner case)。“比如聚积杯子数据时,聚积到的可能都是桌子中间的,健忘聚积桌子旯旮的。这时就不错用宇宙模子生成桌子旯旮的样本,来补足VLA。”
基于这一判断,智平方很早便股东宇宙模子与VLA的会通筹商。2025年11月,智平方承接北京大学率先推出会通宇宙模子的新一代架构Video2Act,初度杀青“先估量、后履行”的机器东说念主模子范式。
他指出,对于“宇宙模子照旧VLA”的争论,正在被新的时间范式所取代。当下,真的遑急的问题依然不再是谁替代谁,而是谁有时率先杀青两者的深度会通。
在智源大会上,郭彦东重心先容了智平方最新发布的类脑具身智能系统NeuroVLA,同期具备主动感知、故障自规复与时序系念三大类生物通顺才略的具身智能系统。
从端到端VLA,到Video2Act,再到NeuroVLA。以前三年,智平方抓续围绕机器东说念主大脑进行系统性翻新。要是说VLA让机器东说念主领有了行动才略,宇宙模子让机器东说念主领有了表露和估量才略,那么NeuroVLA则进一步赋予机器东说念主接近生物系统的反馈与阻抑才略。
南边+记者 郜小平九游体育娱乐网